RTO RPO 개념은 클라우드 서비스의 장애 대비 수준을 정할 때 가장 먼저 합의해야 하는 기준입니다. 서비스가 멈췄을 때 얼마나 빨리 복구해야 하는지, 그리고 데이터를 어느 시점까지 되살려야 하는지 정해두지 않으면 백업 주기도, 서버 이중화 수준도, 비용 계획도 제대로 세울 수 없습니다. 모든 서비스를 무조건 무중단으로 만들려고 하면 비용이 감당할 수 없을 만큼 늘어나기 때문에 목표를 숫자로 정하는 과정이 꼭 필요합니다.
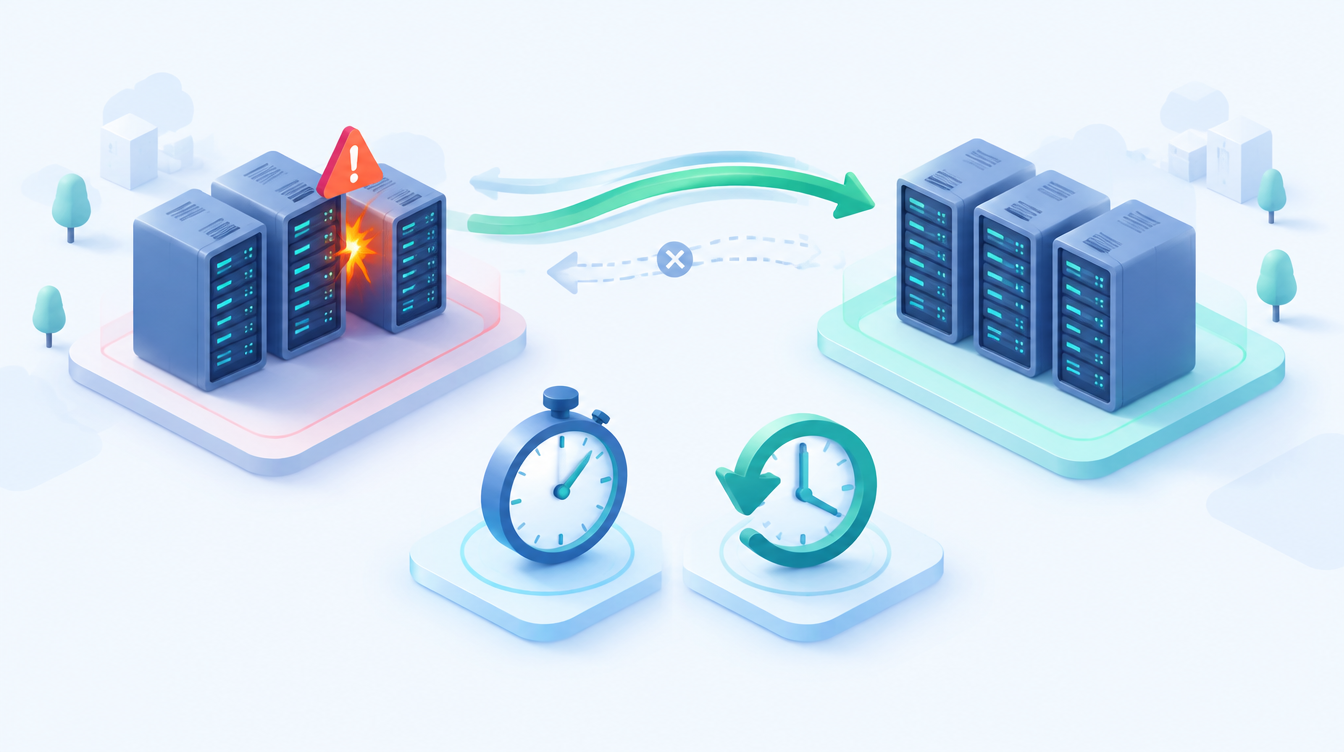
장애 대비라고 하면 서버를 두 대 두면 된다는 정도로 생각하기 쉽습니다. 하지만 실제로 설계하려면 두 대를 같은 가용 영역에 둘지 다른 곳에 둘지, 데이터베이스를 실시간으로 복제할지 하루에 한 번 백업할지 정해야 합니다. 이때 판단 기준이 되는 것이 RTO와 RPO라는 두 숫자입니다.
이 글에서는 두 지표의 의미와 차이, 목표값을 정하는 방법, AWS가 안내하는 재해 복구 전략 네 가지, 멀티 AZ 구성으로 가용 영역 장애에 대비하는 방법, 장애 대비를 검증하는 방법을 차례로 살펴봅니다.
간단히 말씀드리면 RTO(Recovery Time Objective)는 장애 발생 후 서비스를 다시 이용할 수 있게 되기까지 허용되는 최대 시간이고, RPO(Recovery Point Objective)는 장애 시 잃어도 괜찮은 데이터의 최대 기간입니다. RTO와 RPO가 짧을수록 더 높은 수준의 이중화가 필요하고 비용도 커집니다.
RTO는 복구 시간, RPO는 데이터 손실 허용 범위입니다
RTO는 복구 목표 시간입니다. 예를 들어 RTO가 1시간이라면 장애가 발생한 시점부터 1시간 안에 서비스를 다시 정상적으로 제공해야 한다는 뜻입니다. 장애를 감지하는 시간, 원인을 판단하는 시간, 복구 작업을 실행하는 시간, 정상 동작을 확인하는 시간이 모두 이 안에 포함되어야 합니다.
RPO는 복구 목표 시점입니다. RPO가 15분이라면 장애가 발생했을 때 최대 15분 전까지의 데이터는 반드시 되살릴 수 있어야 한다는 뜻입니다. 다시 말해 최근 15분 이내에 입력된 데이터는 잃어버릴 수 있다는 것을 허용하는 기준입니다. 하루에 한 번 백업한다면 RPO는 최대 24시간이 됩니다.
두 지표는 서로 독립적입니다. 온라인 쇼핑몰의 주문 데이터는 RPO가 거의 0에 가까워야 하지만, 한두 시간 정도 서비스가 멈추는 것은 감수할 수 있을 수도 있습니다. 반대로 사내 공지 게시판은 데이터 손실이 조금 있어도 괜찮지만 빠르게 다시 열리는 것이 중요할 수 있습니다.
RTO는 서비스가 멈춰 있어도 되는 최대 시간이고 RPO는 잃어도 되는 데이터의 최대 기간이므로, 두 숫자를 따로 정해야 과하지도 부족하지도 않은 장애 대비를 설계할 수 있습니다.
서비스별 RTO와 RPO 목표를 정하는 방법
목표를 정할 때는 기술보다 비즈니스 영향을 먼저 따져야 합니다. 서비스가 1시간 멈췄을 때 매출 손실이 얼마인지, 고객 신뢰에 어떤 영향을 주는지, 법적 보고 의무가 생기는지를 확인합니다. 이런 영향이 클수록 짧은 목표가 필요합니다.
다음으로 목표를 달성하는 데 드는 비용을 비교합니다. RTO를 몇 시간에서 몇 분으로 줄이려면 대기 서버를 항상 켜두거나 여러 리전에 동시에 운영해야 할 수 있습니다. 장애로 인한 예상 손실보다 대비 비용이 훨씬 크다면 목표를 조정하는 것이 합리적입니다.
모든 시스템에 같은 목표를 적용할 필요는 없습니다. 결제와 주문처럼 핵심적인 시스템은 높은 등급, 내부 보고서나 통계 시스템은 낮은 등급처럼 중요도에 따라 등급을 나누고 등급별로 목표를 정하면 비용을 효율적으로 배분할 수 있습니다.
AWS가 안내하는 재해 복구 전략 네 가지
AWS Well-Architected 프레임워크의 안정성 원칙과 재해 복구 백서에서는 비용과 복구 속도에 따라 네 가지 전략을 소개합니다. 첫 번째는 백업 및 복원(Backup and Restore)입니다. 데이터를 정기적으로 백업해두고, 장애 시 새 환경을 만들어 백업을 복원하는 방식입니다. 비용이 가장 낮지만 RTO와 RPO가 몇 시간 단위로 길어질 수 있습니다.
두 번째는 파일럿 라이트(Pilot Light)입니다. 데이터베이스처럼 핵심 데이터는 복구 리전에 계속 복제해두고, 애플리케이션 서버는 꺼두거나 최소한으로만 준비해둡니다. 장애 시 서버를 켜고 확장하면 되기 때문에 백업 복원 방식보다 빠르게 복구할 수 있습니다.
세 번째는 웜 스탠바이(Warm Standby)입니다. 복구 환경에 축소된 규모의 전체 시스템을 항상 실행해두고, 장애가 발생하면 규모를 늘려 트래픽을 넘겨받습니다. 네 번째는 멀티 사이트 액티브-액티브(Multi-site Active/Active)로, 여러 리전에서 동시에 서비스를 운영해 한쪽이 멈춰도 다른 쪽이 즉시 처리합니다. 복구 시간은 거의 0에 가깝지만 비용과 운영 복잡도가 가장 높습니다.
| 재해 복구 전략 | 평상시 복구 환경 상태 | RTO·RPO 수준 | 비용 수준 |
|---|---|---|---|
| 백업 및 복원 | 백업 데이터만 보관 | 수 시간 단위 | 낮음 |
| 파일럿 라이트 | 핵심 데이터 복제, 서버 최소 준비 | 수십 분 단위 | 중간 이하 |
| 웜 스탠바이 | 축소 규모 전체 시스템 상시 실행 | 수 분 단위 | 중간 이상 |
| 멀티 사이트 액티브-액티브 | 전체 규모로 동시 운영 | 거의 0에 가까움 | 높음 |
재해 복구 전략은 백업 및 복원에서 액티브-액티브로 갈수록 복구가 빨라지는 대신 비용이 커지므로, 앞에서 정한 RTO와 RPO를 만족하는 가장 저렴한 전략을 선택하는 것이 원칙입니다.
멀티 AZ 구성은 가장 기본적인 장애 대비입니다
리전 전체가 멈추는 대규모 재해보다 훨씬 현실적인 위험은 하나의 가용 영역에서 발생하는 문제입니다. 전력 문제나 네트워크 장애가 특정 데이터센터 묶음에만 영향을 주는 경우입니다. 이런 상황에 대비하는 가장 기본적인 방법이 여러 가용 영역에 리소스를 나누어 두는 멀티 AZ 구성입니다.
웹 계층은 Application Load Balancer를 두 개 이상의 가용 영역에 걸쳐 만들고, 그 뒤에 EC2 Auto Scaling 그룹을 여러 가용 영역의 서브넷에 배치합니다. 한 가용 영역의 서버가 응답하지 않으면 로드 밸런서가 상태 확인을 통해 이를 감지하고 정상적인 서버로만 요청을 보냅니다. Auto Scaling은 부족해진 서버 수를 다른 가용 영역에서 자동으로 채웁니다.
데이터베이스 계층은 Amazon RDS의 멀티 AZ 배포를 사용할 수 있습니다. 다른 가용 영역에 대기 인스턴스를 두고 데이터를 동기식으로 복제하므로, 주 인스턴스에 문제가 생기면 대기 인스턴스로 자동 장애 조치가 이루어집니다. 동기식 복제이기 때문에 가용 영역 장애 상황에서 RPO를 매우 짧게 유지할 수 있고, 장애 조치는 보통 몇 분 이내에 완료됩니다.
Amazon S3나 DynamoDB처럼 기본적으로 여러 가용 영역에 데이터를 저장하는 리전 단위 서비스를 활용하면 별도 구성 없이도 가용 영역 장애에 강한 구조를 만들 수 있습니다. 설계할 때 각 구성 요소가 단일 가용 영역에 묶여 있는지 확인하는 것이 중요합니다.
운영 서비스는 로드 밸런서, 서버, 데이터베이스를 모두 두 개 이상의 가용 영역에 분산해야 하며, 한 구성 요소라도 단일 가용 영역에 남아 있으면 그 부분이 전체 장애 지점이 됩니다.
멀티 AZ만으로 막을 수 없는 장애도 있습니다
멀티 AZ 구성은 가용 영역 장애에는 강하지만 모든 문제를 해결하지는 못합니다. 대표적인 것이 데이터 논리 오류입니다. 누군가 실수로 테이블을 삭제하거나 잘못된 배포로 데이터가 망가지면, 그 변경은 대기 인스턴스에도 똑같이 복제됩니다. 이런 경우에는 특정 시점으로 되돌릴 수 있는 백업이 있어야 복구할 수 있습니다.
리전 단위 장애나 계정 권한 탈취도 멀티 AZ로는 대비할 수 없습니다. 중요한 서비스라면 다른 리전으로 백업을 복사하거나 파일럿 라이트, 웜 스탠바이 같은 교차 리전 전략을 함께 고려해야 합니다. Amazon Route 53의 상태 확인과 장애 조치 라우팅을 사용하면 주 리전이 응답하지 않을 때 트래픽을 복구 리전으로 전환할 수 있습니다.
그래서 장애 대비는 멀티 AZ로 일상적인 인프라 장애를 흡수하고, 백업으로 데이터 오류와 삭제에 대비하며, 필요한 경우 교차 리전 전략으로 대규모 재해에 대비하는 여러 층으로 설계하는 것이 바람직합니다.
장애 대비를 실제로 검증하는 방법
설계만으로는 목표를 달성할 수 있는지 알 수 없습니다. 실제로 장애 상황을 만들어 복구 과정을 검증해야 합니다. RDS 멀티 AZ 인스턴스는 재부팅 시 장애 조치 옵션을 선택해 대기 인스턴스로 전환되는 시간을 측정해볼 수 있습니다.
더 체계적인 검증을 원한다면 AWS Fault Injection Service를 활용할 수 있습니다. 인스턴스 중지, 네트워크 지연, 가용 영역 단위의 장애 같은 상황을 통제된 방식으로 발생시켜 시스템이 설계대로 대응하는지 확인하는 서비스입니다. 운영 환경에 적용하기 전에 스테이징 환경에서 먼저 실험하는 것이 안전합니다.
검증 결과는 반드시 기록하고 목표와 비교해야 합니다. 실제 복구에 걸린 시간이 RTO보다 길다면 자동화를 늘리거나 전략을 한 단계 올려야 하고, 복원된 데이터 시점이 RPO보다 오래되었다면 백업이나 복제 주기를 줄여야 합니다.
RTO와 RPO는 문서에 적어두는 숫자가 아니라 정기적인 장애 훈련으로 실제 달성 여부를 확인해야 하는 목표이며, 측정 결과가 목표에 못 미치면 설계를 조정해야 합니다.
RTO와 RPO 핵심 정리
RTO는 장애 후 서비스를 복구하기까지 허용되는 최대 시간, RPO는 잃어도 되는 데이터의 최대 기간입니다. 비즈니스 영향과 비용을 비교해 서비스별로 목표를 정하고, 백업 및 복원, 파일럿 라이트, 웜 스탠바이, 액티브-액티브 가운데 목표를 만족하는 가장 경제적인 전략을 선택합니다. 멀티 AZ 구성은 가용 영역 장애에 대한 기본 대비이고, 데이터 논리 오류와 리전 장애는 백업과 교차 리전 전략으로 보완하며, 정기적인 훈련으로 목표 달성 여부를 검증해야 합니다.
질문 QnA
RTO와 RPO를 0으로 만들 수 있나요?
멀티 사이트 액티브-액티브 구성으로 0에 가깝게 줄일 수는 있지만 비용과 운영 복잡도가 매우 커집니다. 대부분의 서비스는 비즈니스 영향에 맞는 현실적인 목표를 정하는 것이 합리적입니다.
RDS 멀티 AZ의 대기 인스턴스로 읽기 트래픽을 분산할 수 있나요?
기본 멀티 AZ 인스턴스 배포의 대기 인스턴스는 장애 조치용이라 읽기 요청을 받지 않습니다. 읽기 분산이 필요하면 읽기 전용 복제본이나 읽기 가능한 대기 인스턴스를 제공하는 멀티 AZ DB 클러스터 배포를 검토해야 합니다.
개인 프로젝트에도 멀티 AZ 구성이 필요한가요?
실제 사용자가 거의 없는 개인 프로젝트라면 비용 대비 효과가 크지 않을 수 있습니다. 대신 정기 백업과 복원 방법만큼은 준비해두는 것이 좋습니다.
장애가 났을 때 AWS 상태는 어디서 확인하나요?
AWS Health Dashboard에서 서비스 전체 상태와 내 계정에 영향을 주는 이벤트를 확인할 수 있습니다. 중요한 서비스라면 AWS Health 이벤트 알림을 설정해두는 것이 좋습니다.
장애는 언젠가 반드시 일어난다는 전제에서 출발하면 대비가 훨씬 구체적으로 바뀝니다. RTO와 RPO라는 두 숫자는 그 대비를 얼마나, 어떻게 할지 결정하는 나침판 역할을 합니다.
운영 중인 서비스가 있다면 오늘 팀원들과 함께 "몇 시간까지 멈춰도 되는가"와 "몇 분치 데이터까지 잃어도 되는가" 두 가지 질문에 답해보세요. 그 답을 현재 백업 주기와 가용 영역 구성과 비교해보면 가장 먼저 보완해야 할 부분이 분명하게 보이실 것입니다.
함께 읽으면 좋은 글: EBS 스냅샷과 AWS Backup 차이
참고 자료: AWS 리전 및 가용 영역, AWS Backup 안내
※ 본 글은 2026년 9월 기준 AWS Well-Architected 프레임워크 안정성 원칙, AWS 재해 복구 백서, Amazon RDS 멀티 AZ 공식 문서를 참고해 작성했으며, 서비스 기능과 장애 조치 시간은 구성에 따라 달라질 수 있으니 최신 내용은 AWS 공식 페이지에서 확인해 주세요.
'IT 클라우드 정보' 카테고리의 다른 글
| EBS 스냅샷과 AWS Backup 차이 클라우드 백업 3-2-1 규칙 적용 방법 (0) | 2026.09.22 |
|---|---|
| S3 버킷 퍼블릭 액세스 차단 설정 확인으로 데이터 유출 사고 예방하는 방법 (0) | 2026.09.21 |
| S3 스토리지 클래스 종류별 차이와 수명 주기 정책으로 저장 비용 줄이는 방법 (0) | 2026.09.21 |
| 보안 그룹과 네트워크 ACL 차이 상태 저장 방식으로 이해하는 방화벽 규칙 설정 (0) | 2026.09.20 |
| VPC 퍼블릭 서브넷 프라이빗 서브넷 차이와 NAT 게이트웨이가 필요한 이유 (0) | 2026.09.20 |


